Chronique no 031 — 2026
Algorithmes de décision - quand l'IA se trompe en votre nom
Biais, empoisonnement, hallucinations : comment gouverner les IA qui orientent vos décisions - et pourquoi le report européen ne réduit pas le risque.
Un algorithme qui recommande de ne pas investiguer une alerte est un risque de résilience au même titre qu’un rançongiciel. La différence, c’est que personne ne s’en aperçoit.
Le 2 août 2026 devait être une date de bascule : l’échéance à laquelle les obligations européennes sur les systèmes d’IA à haut risque devenaient applicables. Le 27 juillet, à six jours du terme, le règlement (UE) 2026/1744 est entré en vigueur et l’a repoussée au 2 décembre 2027.
Seize mois de plus. Le calendrier a bougé. Les algorithmes, eux, sont déjà en production.
Nous avons abordé l’IA comme un usage non gouverné (009), puis comme un outil de détection au sein du SOC (024). Il manque une troisième lecture, plus discrète et plus structurante : l’IA comme prescripteur. Elle ne se contente plus de voir. Elle classe, elle priorise, elle recommande. Et ce qu’elle recommande finit, dans les faits, par être appliqué.
C’est là que le sujet cesse d’être technique. Une organisation qui délègue son tri d’alertes, son scoring de tiers ou sa priorisation de correctifs à un modèle qu’elle n’audite pas a créé une dépendance. Pas une dépendance d’infrastructure : une dépendance de jugement.
La vraie question n’est pas de savoir si l’IA se trompe. Elle se trompe, comme tout système. C’est de savoir qui s’en apercevra, quand, et selon quelle procédure.
1. Du copilote au prescripteur : un glissement que personne n’a décidé
Aucune note de service n’a acté que l’IA déciderait. Le glissement s’est fait par accumulation.
Un modèle propose un score de criticité : l’analyste, débordé, traite d’abord ce qui est en haut de liste. Un moteur classe les vulnérabilités : l’équipe corrige dans l’ordre proposé. Un assistant rédige la synthèse de crise : le comité de direction lit la synthèse, pas les sources.
Aucune de ces étapes n’est une délégation formelle. Toutes ensemble en constituent une.
Une recommandation que l’on suit systématiquement n’est plus une recommandation. C’est une décision, assortie d’un intermédiaire humain qui tient lieu de signature.
Ce glissement déplace le point de défaillance. Il n’est plus dans l’infrastructure, il est dans l’ordonnancement de l’attention. Un modèle qui range une alerte réelle en position 400 sur 400 produit exactement le même effet qu’un capteur en panne - à ceci près qu’il ne remonte aucune erreur.
La délégation de décision ne se décrète pas. Elle s’installe. Et ce qui s’installe sans décision ne se gouverne pas.
2. Trois modes de défaillance, trois natures de risque
On confond volontiers les défaillances de l’IA. Elles n’ont ni les mêmes causes, ni les mêmes signatures, ni les mêmes contre-mesures.
Le biais est un héritage. Un modèle entraîné sur l’historique des incidents traités apprend aussi l’historique des incidents ignorés. Les angles morts du passé deviennent les règles du présent. Le biais ne produit pas d’erreur visible : il produit une cohérence trompeuse.
La corruption des données est une attaque. Le NIST la documente sous le terme d’empoisonnement dans sa taxonomie AI 100-2. Une analyse conjointe de l’UK AI Security Institute et de l’Alan Turing Institute, reprise par l’ANSSI en février 2026, indique qu’un empoisonnement peut être obtenu à partir de quelques centaines de documents malveillants seulement - et que ce volume varie peu avec la taille du corpus d’entraînement. Autrement dit : la masse de données ne protège pas.
L’hallucination est une production. Le modèle génère un contenu plausible et faux, sans signal de doute. Le CERT-FR en décrit une conséquence concrète : le « slopsquatting », qui consiste à enregistrer des noms de paquets logiciels inventés par des IA, puis à en diffuser des versions malveillantes. L’hallucination d’un modèle devient le point d’entrée d’une attaque par chaîne d’approvisionnement.
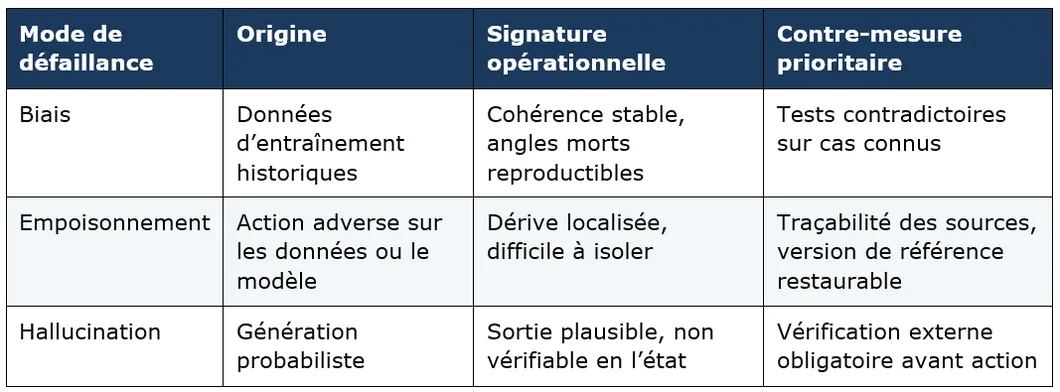
Un dispositif qui traite ces trois modes de la même façon n’en traite aucun.
3. Le vrai risque n’est pas la machine. C’est le biais d’automatisation.
Le règlement européen sur l’IA le nomme explicitement. Son article 14, consacré au contrôle humain, demande que les personnes chargées de la supervision restent conscientes de la tendance à se fier automatiquement aux sorties du système.
La formulation est rare dans un texte réglementaire : le législateur reconnaît que le problème ne tient pas seulement à l’outil, mais à la relation que l’on entretient avec lui.
En situation normale, un analyste conteste. En situation dégradée - fatigue, urgence, volume - il valide. C’est le mécanisme observé de longue date en aéronautique : la compétence de reprise en main s’atrophie précisément pendant les périodes où le système fonctionne bien.
Trois postures sont couramment confondues sous le terme de « supervision humaine » :
L’humain dans la boucle : il décide, l’outil propose. Coûteux, lent, robuste.
L’humain sur la boucle : l’outil agit, l’humain surveille et peut interrompre. Tenable si l’interruption est réellement exerçable.
L’humain en garantie : l’outil agit, l’humain signe. Ce n’est pas de la supervision, c’est de la répartition de responsabilité.
Une supervision humaine qui n’a jamais contredit le modèle n’est pas une supervision. C’est un enregistrement.
4. Ce que le calendrier réglementaire vient de changer - et ce qu’il ne change pas
Le 24 juillet 2026, le règlement (UE) 2026/1744, dit « omnibus numérique sur l’IA », a été publié au Journal officiel de l’Union européenne. Entré en vigueur le 27 juillet, il modifie pour la première fois le règlement sur l’IA de 2024.
Ce qui change : les obligations lourdes pesant sur les systèmes à haut risque de l’annexe III - gestion des risques, documentation technique, journalisation, contrôle humain - passent du 2 août 2026 au 2 décembre 2027. Les systèmes intégrés à des produits déjà réglementés glissent, eux, à août 2028.
Ce qui ne change pas : les obligations de transparence de l’article 50 s’appliquent bien à compter du 2 août 2026, et l’approche par les risques reste intacte.
Il faut lire ce report pour ce qu’il est : non une annulation, mais un décalage motivé par l’absence de normes harmonisées et de dispositifs d’évaluation opérationnels. Le législateur a constaté qu’on ne pouvait exiger la conformité à des règles dont les outils de mise en œuvre n’existaient pas encore.
Pour une direction, la lecture est simple : l’échéance a bougé, l’exposition non. Une organisation qui avait bâti sa trajectoire autour d’une date se retrouve à replanifier. Une organisation qui l’avait bâtie autour d’une doctrine - traçabilité, supervision exerçable, séparation nette entre assistance et décision - a simplement gagné du temps.
Un calendrier réglementaire n’est pas une analyse de risque. Confondre les deux, c’est faire de la conformité, pas de la résilience.
5. Gouverner la confiance algorithmique comme on gouverne un fournisseur
Depuis le début de cette série, la thèse ne varie pas : la résilience ne consiste pas à supprimer la dépendance, mais à avoir conscience de ses dépendances.
Un modèle d’aide à la décision est une dépendance. Il a un fournisseur, une chaîne d’approvisionnement (données, poids, bibliothèques), une opacité, un coût de sortie et un mode dégradé. Exactement comme un hébergeur ou un éditeur.
Nous savons faire. Nous l’avons fait pour le cloud (002), pour les composants open source et propriétaires (003), pour les prestataires critiques. Il s’agit d’appliquer les mêmes réflexes de gouvernance à un objet qui n’a pas encore été reconnu comme un fournisseur.
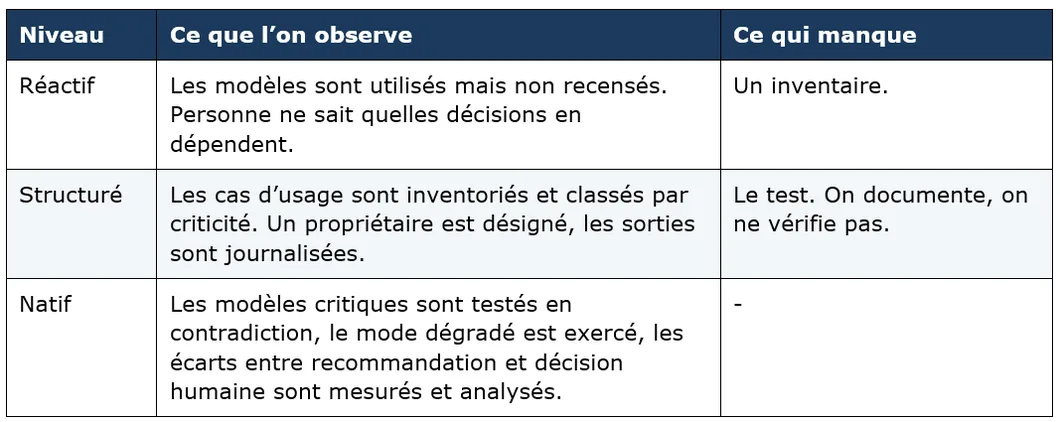
La question n’est pas « faites-vous confiance à votre modèle ? ». C’est « à partir de quel indicateur cesseriez-vous de lui faire confiance ? ».
6. Sept questions avant de laisser un algorithme décider
Une checklist courte, utilisable en comité, sans prérequis technique :
Quelle décision ce système influence-t-il réellement ? Non pas ce qu’il produit, mais ce qui change dans l’organisation à cause de ce qu’il produit.
Quel est le coût d’un faux négatif ? Une alerte manquée coûte-t-elle plus cher qu’une alerte inutile ? Le réglage du modèle reflète-t-il ce coût ?
D’où viennent les données d’entraînement, et qui peut les modifier ?
Existe-t-il une version de référence à laquelle revenir ? Et l’a-t-on déjà restaurée pour de bon, hors exercice de papier ?
Combien de fois, ces six derniers mois, un humain a-t-il écarté la recommandation ? Si la réponse est zéro, la supervision est théorique.
Que se passe-t-il si le système est indisponible 72 heures ? Qui prend le relais, avec quelle procédure, à quel débit ?
Peut-on reconstituer, six mois après, pourquoi cette décision a été prise ? Sans journalisation des entrées et des sorties, la réponse est non.
Sept questions. Si trois restent sans réponse, le système n’est pas gouverné : il est simplement en service.
7. Le mode dégradé cognitif
Nous avons appris, épisode après épisode, qu’une sauvegarde non restaurée n’est pas une sauvegarde. Le raisonnement vaut ici.
Une organisation qui a délégué son tri d’alertes à un modèle pendant deux ans a perdu quelque chose de plus difficile à reconstituer qu’un serveur : la routine de jugement. Les analystes savent lire une sortie de modèle. Savent-ils encore construire une hypothèse à partir de journaux bruts ?
Le fonctionnement sans IA n’est pas une clause de PCA. C’est un exercice. Il se planifie, il se chronomètre, il produit un écart mesurable - et cet écart est un indicateur de résilience aussi sérieux qu’un RTO.
L’ANSSI recommande, dans son guide sur les systèmes d’IA générative, de cloisonner les environnements, de journaliser l’ensemble des traitements et de conserver une version de référence permettant un retour arrière. Ce sont des mesures techniques. Leur finalité est organisationnelle : préserver la capacité de fonctionner sans.
Sans capacité à décider sans la machine, tout le reste est cosmétique.
L’Essentiel pour Agir
- Inventorier les décisions, pas les outils —
Recensez les décisions opérationnelles influencées par un modèle - tri d’alertes, priorisation de correctifs, scoring de tiers, synthèses de crise. C’est cette liste, et non le catalogue d’outils, qui définit votre exposition réelle.
- Mesurer le taux de contradiction —
Suivez la proportion de recommandations écartées par un humain. Un taux nul n’indique pas un bon modèle : il indique une supervision qui ne s’exerce plus. C’est l’indicateur le moins coûteux et le plus révélateur dont vous disposiez.
- Exercer le mode dégradé —
Programmez, une fois par semestre, une séquence de travail sans assistance algorithmique sur un périmètre critique. Chronométrez. L’écart de performance constaté est votre véritable niveau de dépendance.
Conclusion
Un algorithme qui recommande de ne pas investiguer une alerte n’attaque rien, ne chiffre rien, ne déclenche aucune astreinte. Il produit simplement une organisation qui regarde ailleurs, avec constance et bonne foi. C’est une défaillance silencieuse - et les défaillances silencieuses sont les plus longues à corriger.
Le report européen offre seize mois. Ce n’est pas un répit, c’est une fenêtre : le temps de construire une doctrine plutôt qu’un dossier de conformité.
Reste une question que ce trimestre ne pourra pas éviter beaucoup plus longtemps. Nous avons outillé la détection, automatisé la réponse, fiabilisé la décision. À la fin de la chaîne subsiste pourtant un arbitrage que personne n’a encore accepté de confier à une machine. Lequel - et pourquoi celui-là ?
La résilience ne consiste pas à faire confiance à la machine. Elle consiste à savoir précisément où cette confiance s’arrête.
Bibliographie
ANSSI / CERT-FR - « L’IA générative face aux attaques informatiques : synthèse de la menace en 2025 » (CERTFR-2026-CTI-001, 4 février 2026)
https://www.cert.ssi.gouv.fr/uploads/CERTFR-2026-CTI-001.pdf
Source française de référence sur l’empoisonnement des modèles, le slopsquatting et le ciblage des systèmes d’IA. Fournit les éléments factuels des sections II et VII.
NIST - « Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations » (NIST AI 100-2 e2025)
https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.100-2e2025.pdf
Taxonomie de référence des attaques contre les systèmes d’IA prédictive et générative. Sert de base à la distinction entre biais, empoisonnement et détournement.
NIST - « Artificial Intelligence Risk Management Framework (AI RMF 1.0) », NIST AI 100-1
https://nvlpubs.nist.gov/nistpubs/ai/nist.ai.100-1.pdf
Cadre de gestion des risques liés à l’IA. Utile pour structurer la grille de maturité et la notion de fiabilité mesurable d’un système d’aide à la décision.
Règlement (UE) 2024/1689 établissant des règles harmonisées concernant l’intelligence artificielle (« AI Act »)
https://eur-lex.europa.eu/legal-content/FR/TXT/HTML/?uri=OJ:L_202401689
Texte de référence. L’article 14 sur le contrôle humain mentionne explicitement le biais d’automatisation, point central de la section III.
Règlement (UE) 2026/1744 - « train de mesures omnibus numérique sur l’IA » (publié au JOUE le 24 juillet 2026)
https://eur-lex.europa.eu/legal-content/FR/ALL/?uri=OJ%3AL_202601744
Première modification de l’AI Act. Reporte au 2 décembre 2027 les obligations applicables aux systèmes à haut risque de l’annexe III.
ANSSI - « Recommandations de sécurité pour un système d’IA générative » (ANSSI-PA-102, avril 2024)
https://cyber.gouv.fr/publications/recommandations-de-securite-pour-un-systeme-dia-generative
Guide opérationnel : cloisonnement des environnements, journalisation des traitements, conservation d’une version de référence du modèle.